编程 Agent 新评测:任务全对仅 26.4%
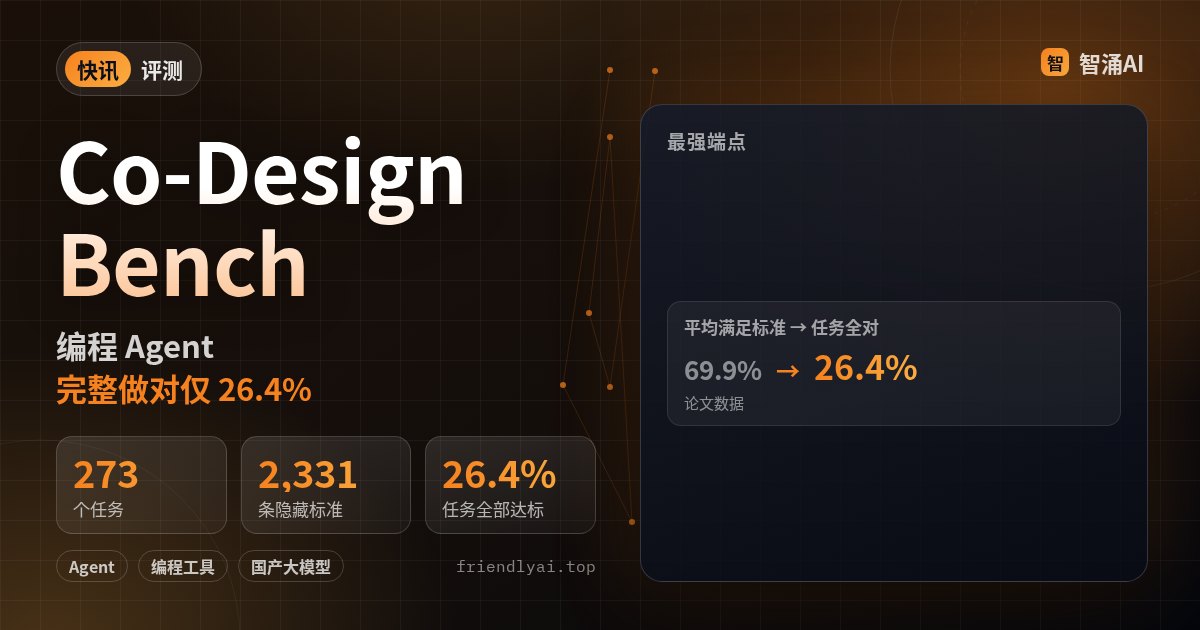
复旦大学、阿里巴巴(Alibaba Token Hub)等团队在 arXiv 发布 Co-Design Bench,测编程 Agent 能不能把真实用户的修改请求变成一个能用的应用新版本。任务来自 26,314 个真实编程会话、去重后的 37,463 条请求,最后整理出 273 个任务。
评分不依赖标准答案代码或目标截图:先由评审模型按源码和浏览器里的证据逐条判定,再让另一个模型专门挑「判为通过」的结论,视觉和交互类结论还要额外审计。论文还发现,仓库编辑涉及三到四类改动时,所有端点的完成率都比只涉及一两类时低。
「大部分做到了」和「整件事做完了」之间差了一大截,这和日常用编程 Agent 的体感一致:它常常改对了七成,剩下的要人收尾。项目页的演示用的是 qwen3.8-max。
注意:这是 10 月 26 日提交的预印本,没有经过同行评审;评分用了大模型评审,结果依赖论文设定的 Agent 框架。各模型的具体排名请看项目页排行榜。