OpenAI:GPT-5.6+ 可开 12h prompt 缓存
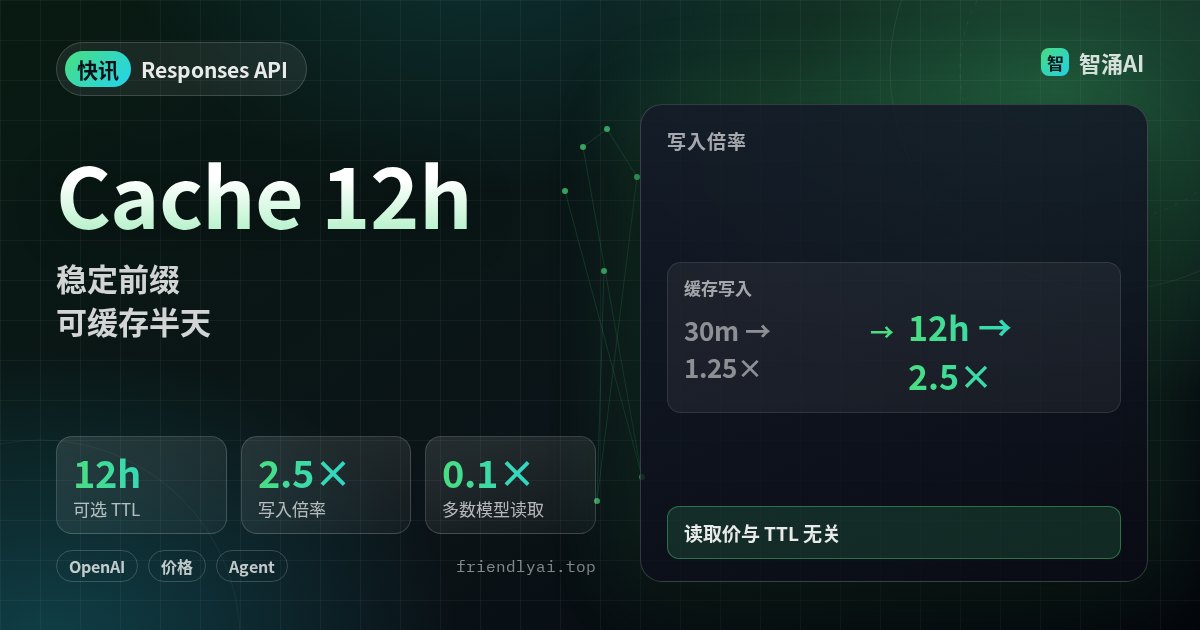
OpenAI 开发者文档更新了 Prompt caching:从 GPT-5.6 起,Responses API 可用 prompt_cache_options.ttl 选择最短缓存寿命——默认 "30m"(写入按未缓存输入价的 1.25×),或 "12h"(写入 2.5×)。缓存读取价与 TTL 无关;多数相关模型读缓存约 0.1× 普通输入,GPT-6.1 Sol 为 0.05×。站内已有短讯;下面按文档核对谁该开 12h、怎么记账、迁移时要注意什么。
发生了什么
Prompt caching 一直在做「同一前缀别重复算 KV」。GPT-5.6 之后,Responses API 把寿命和写入价绑在一起:短会话继续用默认 30 分钟写入倍率;跨半天还要复用的系统说明、工具定义、评分细则,可以单独申请 12 小时最短寿命,代价是写入更贵。文档同时支持 prewarm: true:只预热缓存、不生成正文,适合应用启动时先把共享前缀写进缓存。
usage 里会拆出 cache_write_tokens_details.ttl_30m_tokens 与 ttl_12h_tokens,两者不重叠、加总等于 cache_write_tokens,方便对账。Agents API 的模型调用与 Responses 共用同一套缓存行为;会话本身不保证命中。
为什么重要
长系统提示 + 固定工具表的 Agent,输入费里很大一块是「每次都把说明书再喂一遍」。读缓存 0.1×(或 Sol 的 0.05×)时,前缀写一次、后面九次全命中,总成本会明显低于十次全价输入——文档用 30m 写入倍率举例:一次写入加九次满读约 2.15×,对比无缓存的 10×。12h 把「隔几小时再来的同一工作负载」也纳入可复用范围,但写入 2.5×,必须只打在真正稳定的前缀上。
把整天复用的材料放在最前并给 12h 断点,会话上下文用 30m;当前问题放在最后一个断点之后,避免按高倍率写入一次性后缀。
可核实数字
| 项 | 文档值(GPT-5.6+ / Responses) |
|---|---|
| 默认 TTL | "30m",写入 1.25× 未缓存输入价 |
| 可选 TTL | "12h",写入 2.5× |
| 读取价 | 与 TTL 无关;多数模型 0.1×,GPT-6.1 Sol 0.05× |
| 最低可缓存前缀 | 1024 可见输入 token(不含隐藏系统段) |
| 单请求缓存写入上限 | 最多 4 次(隐式断点也会占其中一个名额) |
缓存存在单机 GPU 侧的加密 KV 状态,不跨组织、不跨区域处理边界共享。路由拥塞时可能打到没有条目的机器——命中率要用 cached_tokens / 总输入自己盯,不能假设「前缀一样就一定命中」。
一个主对比
| 30m(默认) | 12h | |
|---|---|---|
| 适合 | 多轮对话、Agent 短间隔复用 | 跨半天仍不变的说明书 / 参考资料 |
| 写入倍率 | 1.25× | 2.5× |
| 读取倍率 | 相同(模型档) | 相同(模型档) |
| 风险 | 隔太久要重写前缀 | 把易变后缀也写成 12h → 白白多付写入 |
同一请求里可以混用:请求级默认 30m,某个显式断点覆盖为 12h。文档的计费表还提醒:若前缀已有有效 30m 覆盖、你再写一条覆盖到 12h,会按 12h 重新计写入,不会退回已付的 30m 写入费。
谁该关心 / 怎么试
适合:客服/评审类「同一套 rubric + few-shot」、工具定义很少改的编码 Agent、启动时就能预热的交互应用。不适合:前缀每次都改用户名/时间戳、或前缀本身够不到 1024 token 却指望省钱的短提示——文档还画了「最低长度陷阱」:有时略加长稳定材料反而更划算。
迁移清单(文档原文要点):保留稳定前缀;用 ttl 替换 prompt_cache_retention;确认可缓存长度;若默认隐式断点把易变后缀也写进去,在稳定段后加显式断点,或改用 mode: "explicit"。GPT-5.6+ 上 prompt_cache_key 主要用来做客户/用户分账,不再是冲命中率的必选项;更早模型仍建议稳定 key 辅助路由。
注意:全部倍率与字段以 OpenAI Prompt caching 文档为准;实际 OTPS/命中随负载与路由变化。本站未跑付费 API 对账。
最后
如果你的 Agent 系统提示和工具表一周都不大改,打开文档把稳定段提到最前,设一个 12h 显式断点,再用 usage 里的 ttl_12h_tokens 对一笔账。价格页与 Prompt Caching Dashboard 一起看,比只记一句「缓存能省钱」更靠谱。