Agent Code Mode 入门:一个执行工具替代几十个工具
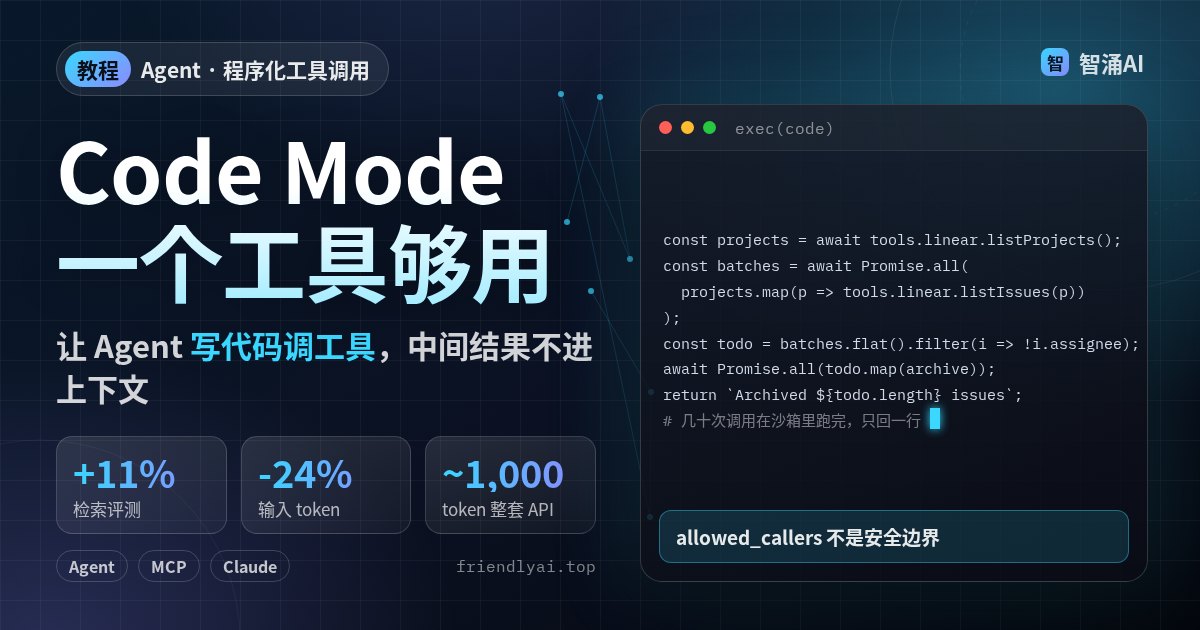
给 Agent 接了几十个工具、几个 MCP 服务器以后,上下文先被工具定义吃掉一大块,每次调用的结果还要回到对话里,模型再想一轮才能走下一步。Code Mode(也叫程序化工具调用)的做法是只给模型一个 exec(code):模型写一段 TypeScript 或 Python,在沙箱里把查询、过滤、并行调用串完,只把最后结果交回上下文。下面按 Anthropic、Cloudflare 的官方文档(2026-11-03 北京时间查阅),讲清楚它怎么工作、怎么接、哪里会出问题。
一轮一个动作,是工具调用最大的浪费
标准工具调用的节奏是:模型吐一个 JSON 动作(最多一批互不依赖的调用),等结果原样塞回历史,再推理,再决定下一步。读 3 个来源要 3 轮,查 12 个项目再逐个归档要几十轮,中间每份原始数据都进上下文。
Code Mode 把整本工具目录编成类型声明交给模型,比如 declare namespace tools { ... }。模型需要组合动作时,写一段脚本:
const projects = await tools.linear.listProjects();
const batches = await Promise.all(
  projects.map((p) => tools.linear.listIssues({ projectId: p.id }))
);
const unassigned = batches.flat().filter((i) => !i.assignee);
await Promise.all(unassigned.map((i) => tools.linear.archiveIssue({ id: i.id })));
return `Archived ${unassigned.length} issues across ${projects.length} projects.`;
这是一段示意代码(工具名按你的实际接口替换):几十次底层调用在沙箱里跑完,回到模型上下文的只有最后一行汇总。
做什么仍由模型决定,多步之间的数据由代码传递,不用每步回到上下文。
两家官方给的数字
| 来源 | 做法 | 官方数字 |
|---|---|---|
| Anthropic 程序化工具调用 | Claude 在代码执行容器里写 Python 调你的工具 | BrowseComp、DeepSearchQA 等检索评测上,在基础搜索工具之上加这层,平均效果 +11%,输入 token -24% |
| Cloudflare API 的 Code Mode MCP | 只暴露 search()、execute() 两个工具 | 覆盖整套 Cloudflare API 约 1,000 token;不用 Code Mode 的等价 MCP 要约 117 万 token,输入 token 减少 99.9% |
两组数字都是厂商在自己场景里测的,换成你的工具集结果会不同,拿来判断方向就够了。
做法一:Claude API 上打开程序化工具调用
前提是请求里带代码执行工具 code_execution_20260120 或更新版本,再给想从代码里调用的工具加 allowed_callers:
{
  "tools": [
    {"type": "code_execution_20260120", "name": "code_execution"},
    {
      "name": "query_database",
      "description": "Execute a SQL query against the database",
      "input_schema": { "...": "..." },
      "allowed_callers": ["code_execution_20260120"]
    }
  ]
}
流程是:Claude 写 Python,把工具当函数调;代码执行到工具调用时暂停,API 返回一个 tool_use 块,其 caller 字段标明是程序化调用;你回传结果后代码继续跑,中间结果不进上下文;全部跑完 Claude 才拿到最终输出。
allowed_callers可选["direct"](默认)、["code_execution_20260120"]或两者都写。文档建议每个工具二选一,给模型的信号更清楚。code_execution_20260521和 20260120 是同一个运行时,区别是工具说明里告诉 Claude 每个 Python 单元格有 90 秒墙钟上限,方便它拆分长任务。- Claude Haiku 4.5 接受新版代码执行工具,但不支持程序化工具调用。发请求前可以读 Models API 里的
capabilities.code_execution.supported确认。
做法二:把现有 MCP / OpenAPI 包成代码接口
Cloudflare Agents SDK 的 @cloudflare/codemode/mcp 给了两种包法:
| 模式 | 对外工具 | 适合 |
|---|---|---|
codeMcpServer({ server, executor }) | 一个 code | 已有 MCP 服务器,工具数量可控;上游工具变成沙箱里 codemode 的方法 |
openApiMcpServer({ spec, executor, request }) | search + execute | 大型 API,完整 schema 不该进上下文;search 在沙箱里查文档,execute 调 codemode.request() |
模型写的代码跑在隔离的 Worker 里,DynamicWorkerExecutor 默认屏蔽直接的 fetch() 和 connect(),代码只能经由上游 MCP 工具或宿主提供的 request 回调访问外部。凭证留在宿主回调里,沙箱里的代码只拿到可调用的函数,拿不到密钥。openApiMcpServer 的文本响应约 6,000 token 截断并带截断标记。
为什么是 JS/Python 沙箱,不直接给 bash
bash 也能串命令,但有几处吃亏:类型化函数可以直接 Promise.all、try/catch,不用和 shell 转义较劲;有了类型声明,模型不用先跑一圈 --help 摸参数;工具返回 JSON 时,代码直接解析成数据结构继续用。另一个原因是权限边界:每次工具调用都要经过宿主,宿主可以注入凭证、校验参数、在危险操作前停下来等确认。上面两家的实现都是这个思路,Cloudflare 的执行器还提供 globalOutbound 选项,默认 null 即禁止出网。
哪些场景先别用
工具只有三五个、每次只调一两个的 Agent,改成 Code Mode 收益很小,反而多了一层沙箱要维护。Anthropic 文档自己给了反例:在每轮只做一两个顺序调用的 τ²-bench 上,打开程序化工具调用分数不变,成本反而高约 8%;另一边,一个 75 个工具的项目管理 Agent 评测里,计费输入 token 降了约 38%,准确率不变。每一步都需要人看一眼再决定的流程(比如改生产配置),也不适合一次性写成脚本跑完。Anthropic 文档还列了几条硬限制:代码等待一次工具结果约 4 分钟就超时,闲置容器约 5 分钟回收,要在响应的 expires_at 之前回传;回传结果的那条 user 消息只能含 tool_result 块;strict: true 的工具和 disable_parallel_tool_use: true 都不支持。适合的是读多写少、步骤可预期、单步结果很大但最终只要一个汇总的任务,比如批量查询、对账、从多份文档里抽字段。
常见坑
- 把 allowed_callers 当安全边界:Anthropic 文档明说它只影响工具怎么呈现给模型,不是 API 级的硬拦截,客户端仍要能处理任何工具的直接
tool_use。权限检查放在工具实现里。 - 以为沙箱替你做了授权:Cloudflare 文档同样强调代码执行不等于授权,权限和审批放在上游工具处理器或宿主回调里,先查再执行副作用。
- 失败恢复没设计:一段脚本里跑到第 30 次调用失败,前 29 次的副作用已经发生。批量写操作要幂等,或者用可重放的步骤记录。Cloudflare Code Mode 运行时的
step(name, fn)会记录结果,重放时直接返回记录值;rollback()会按调用倒序执行带revert的连接器方法,没有revert的照样保留。 - 老工具不适配:很多 CLI、Skill 是按 bash 和人读文本写的,输出没有结构。迁移前先挑几个高频工具补
outputSchema,模型才能在拿到运行结果前就把 A 的输出接到 B。
完成标准
- 一个原本要 5 轮以上的多步任务,在一次代码执行里完成,上下文里只留摘要。
- 工具实现层有独立的权限检查,不依赖模型「听话」。
- 脚本中途失败时,能说清哪些副作用已经发生、怎么补。
最后
先别急着把所有工具都改成 Code Mode。挑一条「查一批、筛一遍、再逐个处理」的高频流程试,对比改造前后的轮数和输入 token。MCP 本身还不熟的话,先看本站的 MCP 是什么与配置教程。