Claude API 消息线程:长对话只发增量的接法与重放
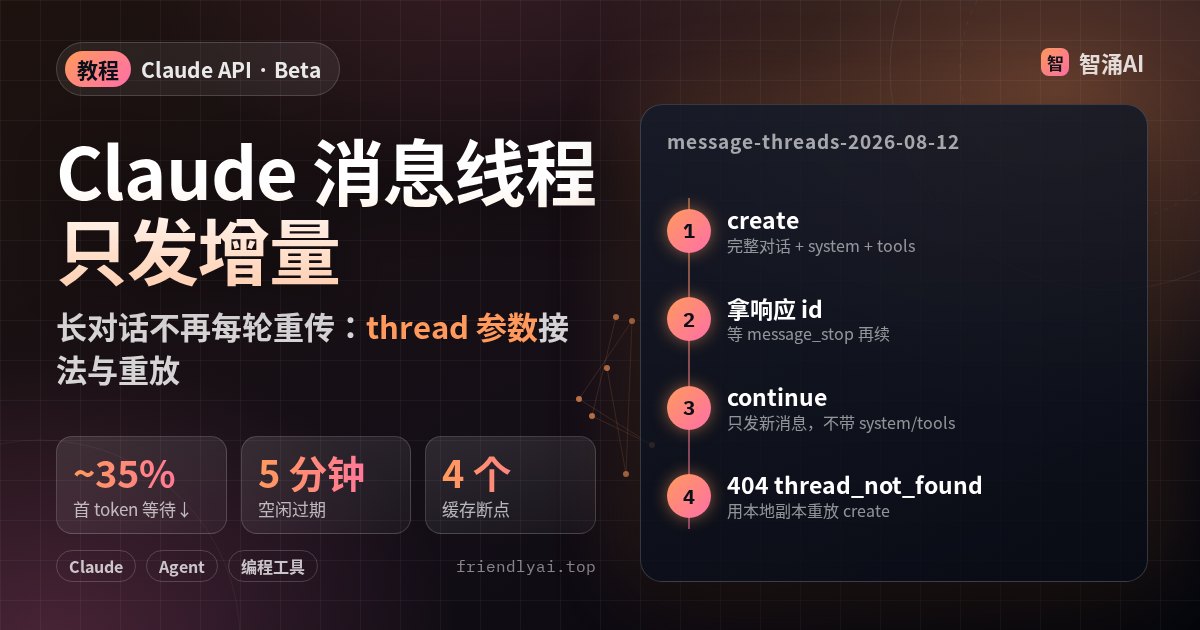
Anthropic 给 Messages API 上了「消息线程」(message threads)公测:第一轮把完整对话发一次,之后每轮只发新消息和上一条回复的 id,服务端替你把前文拼回去。官方说 Claude Code 已经给大多数用户默认打开,50 万到 100 万 token 的请求,首 token 等待时间中位数降了约 35%。下面按官方文档(2026-11-03 北京时间查阅)把接法、哪些字段能改、断了怎么补讲清楚。
它解决的是「每轮重传」的慢
Messages API 本来是无状态的,每次请求都要带上之前全部消息和工具结果。一个编程 Agent 一次会话可能发几百个请求,对话涨到几十万 token 以后,光是上传、校验、分词这些前文,就会拖慢 Claude 开始回复的时间。
线程的做法是把对话在服务端短暂存一会儿。你照常发第一轮,加上 "thread": {"type": "create"};API 把这轮连同 Claude 的回复存在响应 id 下。下一轮只发新消息,加上 "thread": {"type": "continue", "previous_message_id": "上一轮的 id"},API 先把前文拼好再调模型。返回的还是普通 message。
请求变小了,Claude 每轮照样读完整对话,所以 token 用量和价格都不变。
前置条件
- 一个 Claude API key。线程在 Claude API、Claude Platform on AWS、Google Cloud 上的 Claude(Anthropic 托管)和 Microsoft Foundry 上都是 beta,所有模型可用。
- 官方 SDK(文档给了 Python、TypeScript、Go、Java、C#、PHP、Ruby 的示例),或者直接用 curl。
- 每个属于线程的请求都带 beta 头
anthropic-beta: message-threads-2026-08-12。SDK 的线程助手会自动加。
第一步:用 SDK 助手,最省事
Python 版的写法,文档原样:
import anthropic
client = anthropic.Anthropic()

# 创建助手,这一步不发请求
thread = client.beta.messages.thread(
    model="claude-opus-5-5",
    max_tokens=1024,
    cache_control={"type": "ephemeral"},
    system="You are a support agent for Acme. Keep replies short.",
)

# 第 1 轮:助手发 create,带完整对话
thread.send({"role": "user", "content": "Hi! I have a question about an order."})

# 第 2 轮:助手发 continue,只带新消息
second = thread.send({"role": "user", "content": "How long does standard shipping usually take?"})
助手替你做了几件事:加 beta 头;continue 时自动去掉 system 和 tools;遇到 thread_not_found、thread_already_continued、thread_continue_in_flight 时用内存里的完整对话重放一次;被拒答(refusal)后下一轮自动开新线程。SDK 的 beta tool runner 默认也走线程,可以在创建时关掉。
顶层 cache_control 是可选的。线程本身不替你做提示缓存,想每轮都缓存,就在每个请求上带同样的顶层 cache_control。
第二步:自己拼请求时,记住三类字段
不用助手、直接 curl 或用普通 create 时,最容易踩的是字段规则。文档把字段分成三组:
| 分组 | 字段 | 规则 |
|---|---|---|
| 只在 create 发 | system、tools | continue 里带上(哪怕是 null)直接 400 |
| 固定 | model、tool_choice、thinking、mcp_servers(授权 token 除外)、context_management、output_config、container 里的 skills、顶层 cache_control、beta 头集合 | 每轮都要发,值和 create 一致;不一致报 thread_fingerprint_mismatch,错误信息会点名哪个字段 |
| 可变 | max_tokens、stop_sequences、stream、metadata、service_tier 等 | 每轮可以不一样 |
两点容易漏:API 不存 MCP 服务器 URL、MCP 授权 token 和 container 的 id,用到就每轮都带;想换 system 或工具,只能发一个新的 create 开新线程。
# 第 2 轮:只发新消息,不带 system / tools
curl -sS --fail-with-body https://api.anthropic.com/v1/messages \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "anthropic-beta: message-threads-2026-08-12" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-opus-5-5",
    "max_tokens": 1024,
    "cache_control": {"type": "ephemeral"},
    "messages": [{"role": "user", "content": "How long does standard shipping usually take?"}],
    "thread": {"type": "continue", "previous_message_id": "'"$message_id"'"}
  }'
continue 里只放「上一轮之后的新消息」:通常是下一条用户消息,或者回应上一轮 tool_use 的 tool_result。API 不会比对你重发的旧消息,重复发会让同一条消息在对话里出现两次,或者直接报错。
第三步:把重放路径写在最前面
线程是「尽力而为」的:最后一次请求后 5 分钟过期,最长 1 小时内删除。每存下一轮回复,5 分钟重新计时。continue 失败时返回 404,error.details.error_code 为 thread_not_found,响应不说原因。文档列的原因包括:过期;上一轮没被存(比如被 max_tokens 截断在工具调用中间);上一轮由 fallback 模型生成;上一轮还在生成;换了组织、工作区或 API key;新消息里出现了已存对话装不下的东西,比如原本没有图的对话里加了第一张图。
所以你的应用要自己保留每条消息的副本,这份副本才是对话的唯一可信来源。恢复办法只有一个:用副本发新的 create(带上 system 和 tools),再从新 id 继续。重放前把旧消息上的 cache_control 断点去掉,只在最后一块留一个,因为带线程的请求最多 4 个断点,顶层 cache_control 算一个,create 时 system/tools 上的断点每轮都要重新计数。
流式场景再补一条:响应 id 在 message_start 就到了,但要等收到 message_stop 再 continue,提前发可能 404。流在中途断了,先原样重发 continue;如果回 thread_already_continued 或 thread_continue_in_flight,就走重放。
和提示缓存、压缩各管一段
这三样经常被放在一起说,分工如下:
| 功能 | 省什么 | 你要做什么 |
|---|---|---|
| 消息线程 | 上传和预处理前文的时间(首 token 延迟) | 加 thread,自己留副本、写重放 |
| 提示缓存 | 重复前缀的输入 token 费用和处理时间 | 放 cache_control 断点 |
| 压缩 / 摘要 | 上下文长度本身 | 用摘要替换旧轮次;在线程里只能开新线程 |
线程和缓存可以叠加:文档示例就是每轮带顶层 cache_control,前文从缓存读,新一轮写进缓存。
常见坑
- 同一个 id 续两次:线程只能追加,每个响应
id只能被 continue 一次,并发分叉会报thread_already_continued。要分支就用thread.fork()或新 create。 - 想靠它省钱:官方写明价格和限速都不变。账单的问题要靠提示缓存或压缩对话去解决。
- 想在线程里压缩:按需压缩(compaction)和大部分 context editing 不支持线程,Message Batches 和 token 计数接口也不支持。要压缩就自己写摘要,用摘要开新线程。
- pause_turn 后乱发消息:
stop_reason为pause_turn时,用空messages列表 continue;这时发新的 user 消息会被拒。 - 合规场景:线程不符合零数据保留(ZDR),开了 HIPAA readiness 或 Inference hooks 的组织不能用。数据只在内存里、用服务端密钥加密,不落盘。
完成标准
- 第二轮起请求体里只有新消息,没有
system/tools,响应正常。 - 故意等 5 分钟以上再发 continue,能收到 404 并自动用副本重放成功。
- 日志里能看到每轮的
id链,没有出现thread_fingerprint_mismatch。
最后
适合用线程的是活跃的长会话:编程 Agent、带截图的 computer use、文档和图片多的工作流,上下文越长收益越明显。短问答、批处理、对合规有硬要求的场景,照旧发完整对话就行。长会话里上下文怎么涨、什么时候该压缩,可以对照本站的 Claude Code 自动压缩窗口教程,先量一下你的会话平均有多长,再决定要不要接线程。