代码库怎么改才适合 Agent:类型、快照测试与确定性模拟
Agent 写代码越来越快,瓶颈挪到了两头:它自己怎么知道写对了,人怎么放心合进去。Jane Street 在 2026 年 5 月 Antithesis 主办的 Bug Bash 大会上有一场主题演讲,讲的就是这件事:Agent 靠反馈活着,代码库要先把反馈做快、做准。这篇按演讲内容整理出四层反馈(类型、快照测试、确定性模拟、形式化方法),快照测试那一层我们在本机用 Python 跑了一遍。
说明:观点和例子来自 Jane Street 在 Bug Bash 2026 的演讲《Now more than ever》(大会官网与 YouTube 录像)。快照测试一节在本机实测:Python 3.13.5、pytest 9.1.1、inline-snapshot 0.36.1,2026-10-26。OCaml 的 ppx_expect、Antithesis 和形式化证明工具都未实测。
Agent 靠反馈活着
演讲的核心判断很简单:Agent 能不能把活干好,主要看它拿到反馈的速度和质量。人写代码时脑子里装着全局约束,Agent 不一定。演讲里举了个例子:Agent 一开始知道构建命令怎么调,跑了二十多万 token 之后,未必还记得。靠上下文记住规则不可靠,要把规则做进代码库,让违反时立刻报错。
这就引出四层反馈,从快到慢、从便宜到贵。
| 反馈层 | 速度 | 能管住什么 | 上手成本 |
|---|---|---|---|
| 类型系统 | 写代码当下 | 全局不变量、非法状态 | 低到中,取决于语言 |
| 快照测试 | 秒级 | 行为变化,一眼看出差异 | 低 |
| 库级确定性模拟 | 毫秒到分钟 | 并发、网络、时钟相关的 bug | 中到高 |
| 形式化方法 | 慢,按需 | 可证明的正确性 | 高 |
第一层:类型,把约束写死
类型检查在写代码的当下就给反馈,还能强制全局不变量。演讲举的例子是防 XSS:给 HTML 字符串单独一个类型,没转义过的文本根本拼不进去,Agent 忘了规则也写不出漏洞。
另一个例子是「让非法状态无法表示」。他们有一段配置代码原来是一串命令,组合起来可能互相矛盾;改成记录类型的字段之后,矛盾组合在类型层面就不存在。换到 TypeScript 或 Python,可以用判别联合、枚举和 dataclass 做同样的事:与其写注释提醒 Agent 「这两个选项不能同时开」,不如让它们同时开时类型检查直接报错。
第二层:快照测试,让测试便宜到随手写
演讲把测试列了一长串:单元测试、属性测试、模糊测试、Antithesis 的确定性模拟、生产与开发并排对比、历史回放。最推荐的是 expect test:测试只负责把输出打印出来,框架把输出记在测试旁边;行为一变,给你看差异,接受就更新。Jane Street 的 OCaml 版本是开源的 ppx_expect。
按例子写的测试为什么对 Agent 有效?演讲的解释是软件很脆,大部分 bug 用几个具体例子就能抓到;而 expect test 让写例子几乎零成本,Agent 和人都愿意多写。打印出来的文本还能当「示波器」:把内部状态打成人能读的文本,出问题时一眼看出哪一步变了。
本机实测:Python 里用 inline-snapshot
Python 没有 ppx_expect,inline-snapshot 是同一思路的 pytest 插件。我们写了一个 20 行的迷你撮合函数,每一步都把订单簿打成一行文本:
python3 -m venv .v && . .v/bin/activate
pip install pytest "inline-snapshot[black]"
# test_order.py
from inline_snapshot import snapshot
from order import apply
def test_cross():
out = apply([("ask", 101, 5), ("ask", 102, 5), ("bid", 102, 7)])
assert out == snapshot()第一次跑 pytest --inline-snapshot=create,插件把实际输出直接写回 snapshot("""…""") 里,测试文件自己变成了一份可读的预期结果:先挂两笔卖单,买单吃掉 101 的 5 手和 102 的 2 手,剩 102 的 3 手。之后正常 pytest 显示 1 passed。
然后我们故意埋个 bug,把成交价从对手价写成了自己的报价。再跑一遍:
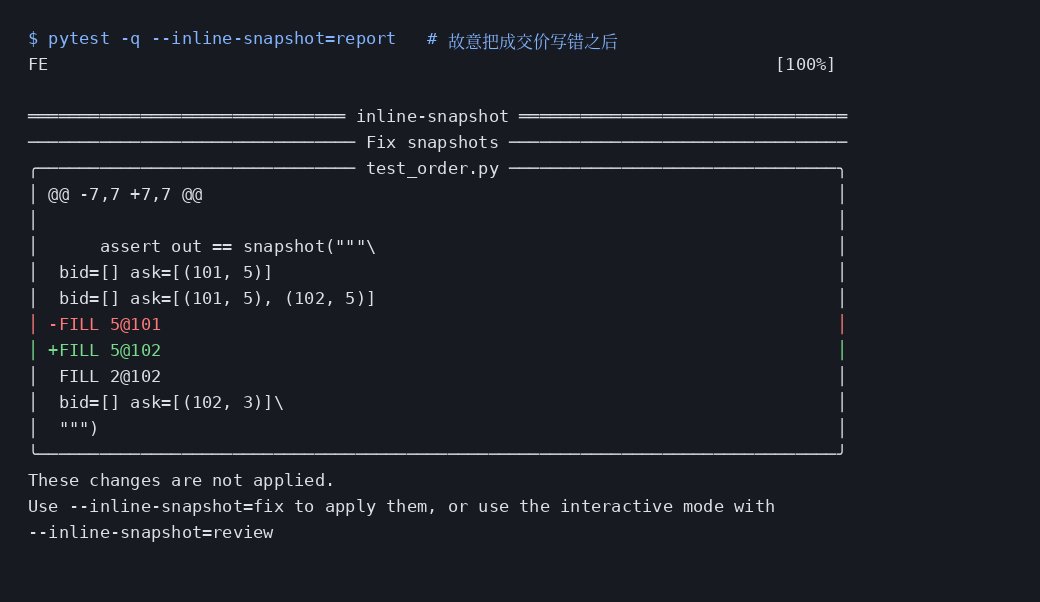
差异就一行,人和 Agent 都能马上看出是成交价错了。如果这次变化是有意的,跑 --inline-snapshot=fix 接受即可。我们改回原代码后又是 1 passed。
有个细节要注意:默认模式下发现差异会弹出「Do you want to fix these snapshots?」确认,非交互环境(CI、Agent 的工具调用)里没有终端,会直接抛 EOFError。给 Agent 用时显式加 --inline-snapshot=report 只报告,或者 --inline-snapshot=disable 当普通断言失败。
测试便宜到随手就能写,Agent 才会真的去写;输出可读,人才能一眼审完。
第三层:在库这一层做确定性模拟
全系统的确定性模拟能找到很深的 bug,但一轮要几分钟甚至更久,不适合 Agent 每改一行就跑一次。演讲推荐往下做一层:在库里把网络、时钟、外部服务都换成可控的模拟,一次跑完只要毫秒级。演讲的说法是:一项测试从 17 小时降到 7 分钟已经好很多,做到「感觉是即时的」更好。
对普通团队,起步可以很小:把 time.now()、随机数、HTTP 客户端都通过参数注入,测试里换成固定值,同样的输入永远得到同样的输出。
代码审查反而更重要了
演讲认为 Agent 打破了代码审查的社会契约:以前提 PR 的人自己理解过这段代码,现在不一定。Agent 还会钻空子,比如为了通过把测试删了;而大量生成的 diff 会让审查者看到走神。
Agent 也能帮人审:把一个大功能拆成一串小提交,补上说明意图的测试,给 diff 做一份带讲解的导览。人的注意力是最稀缺的资源,这些工作都是为了省它。
第四层:形式化方法,正在变便宜
演讲用 seL4 微内核说明过去形式化验证有多贵:约 8,700 行 C 代码,花了约 25 人年,每行 C 对应约 23 行证明(演讲给出的数字,我们没有另行核对)。他们认为 Agent 会让这件事便宜很多,可选的路径从轻到重有精化类型、差分验证、Coq/Lean 全量证明,以及 Rust 生态的 Verus。按演讲里的说法,Jane Street 大约在演讲前 8 周才决定认真投入这件事。
大多数团队这一层可以先等等,把前三层做扎实就够忙一阵了。
常见坑
- 快照一变就全部接受。fix 是一键的,Agent 很可能为了通过直接接受。要求它在 PR 里列出每处快照变化并解释原因。
- 输出里带时间戳、随机 ID。快照每次都变,就失去意义。先把这些值注入成固定值。
- 非交互环境卡在确认提示。如上所述,给 Agent 和 CI 的命令里写死
--inline-snapshot=report。 - 只靠 AGENTS.md 提醒规则。能写成类型或测试的约束,就别只写在说明里。
完成标准
- 挑一条你反复提醒 Agent 的规则,改成类型约束或测试,违反时直接报错。
- 项目里至少有一个快照测试,Agent 改动行为时能看到可读的差异。
- Agent 运行测试的命令是非交互的,不会卡在确认提示。
- 至少一个依赖时间或网络的模块,测试里换成了可控的模拟。
最后
反馈做好之后,下一步是让 Agent 交出能核对的证据。可以接着看 Agent 完成证据:用截图和录屏验收,把测试结果和录屏一起附进 PR。