Agent 只留一个 bash 工具:删掉 90% 外壳后怎么算账
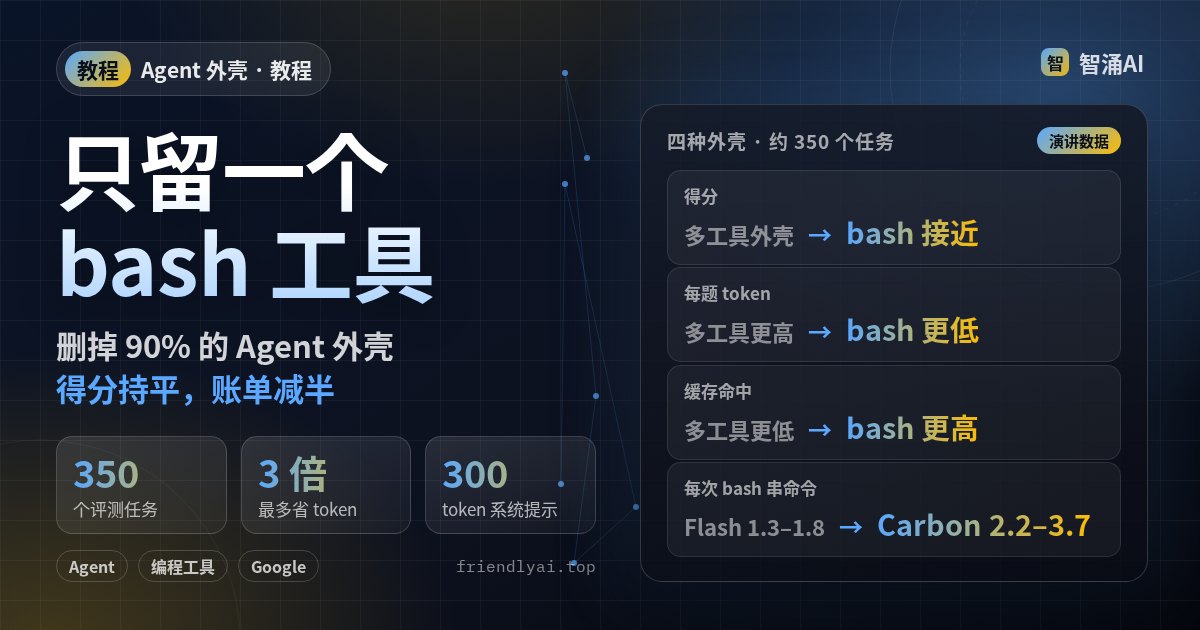
给编程 Agent 配工具,常见做法是越配越多:读文件、写文件、搜索、编辑、计划、待办,各来一个。Google DeepMind 的 Philipp Schmid 在美国时间 11 月 11 日的 AI Engineer Code Summit 上讲了反方向的实验:把专用工具全部删掉,只留一个 bash,系统提示压到约 300 token。约 350 个任务跑下来,几种外壳的得分差不多,花掉的 token 和钱差了一截。这篇按演讲官方页面、字幕和 Pi 文档,整理他的单工具设计,以及怎么用同样的办法给自己的 Agent 外壳算一笔账。
只留一个工具,他是怎么设计的
按演讲字幕,这个工具叫 bash,每次在一个干净的子 shell 里执行,参数很少:
command:要跑的命令。description:一句说明,方便给用户展示 Agent 在干什么。- 异步阈值:命令超过设定毫秒数还没结束,工具调用先返回,模型拿到一个本地文件句柄,之后自己去读日志、看进程是否还在。跑开发服务器、长测试时,前台启动的任务会自动转到后台。
其他工具的职责被文件系统和 shell 接走了:计划和记忆写进文件,不需要专门的计划工具和记忆工具;Agent 本身是 CLI 的话,可以用 bash 调用自己,也就省了子 Agent 工具。唯一补回来的是一个看图工具,因为 cat screenshot.png 只会把二进制塞进上下文,模型看不到图。
演讲简介里还写了两点:系统提示砍到 300 token,执行循环改成异步。
得分差不多,账单差一倍
他用自己约 350 个任务的评测集,覆盖编程、知识工作和终端操作,在 Gemini 4 系列模型上比了四种外壳:只有 bash、bash 加看图工具、两种带结构化文件工具的外壳。官方页面的说法是几种外壳得分相差约 6 个百分点以内,token 用量差别很大。
| 指标 | 演讲里的观察 |
|---|---|
| 得分 | 四种外壳接近,每题只跑了一次,小差异可能是噪声 |
| 每题 token | 只给 bash 时更低 |
| 缓存命中率 | 只给 bash 时更高 |
| 每题成本 | 以 bash 加看图为基准,比工具更多的外壳便宜将近一半 |
| 每次 bash 串几条命令 | Gemini 4 Carbon 约 2.2 到 3.7 条,Gemini 3.5 Flash 约 1.3 到 1.8 条 |
差别出在改代码这一步。给了专用编辑工具,模型读文件时会并行,但一到改代码就一轮改一处,每改一处都要回到模型一次。只给 bash,较强的模型会先用 ripgrep 定位,再写一段内联 Python 脚本一次改完所有位置。他在演讲里说,Carbon 在同一任务上最多少用 3 倍 token。较弱的 3.5 Flash 用 bash 也是一条命令一轮,换不换工具区别不大。
外壳设计得别扭,强模型照样能绕过去把题做对,代价是多出来的轮次和 token,通过率表上看不出来。
前置条件
- 一个能切换工具组合的 Agent 外壳。下面用 Pi(earendil-works/pi,MIT),演讲里的演示也用它。
- Node.js 22.19 或更新版本(Pi 的要求),一个模型的 API key 或订阅。
- 一组你自己的真实任务,10 到 30 个就够起步,每个任务要有能自动判断对错的检查。
- 在隔离环境里跑:只给 bash 意味着 Agent 能执行任意命令,别在有生产凭证的机器上做实验。
第一步:装 Pi,确认默认工具
curl -fsSL https://pi.dev/install.sh | sh
cd /path/to/eval-repo
pi            # 进去后用 /login 连上模型
Pi 默认开的工具是 read、bash、edit、write,另有 grep、find、ls 可选。它本身不带子 Agent 和计划模式,正好适合做减法实验。
第二步:同一个任务,换三种工具组合
--tools 写纯名字时会整个替换工具列表,要用的都得写上:
# A:默认四件套
pi --mode json "修复 tests/test_parser.py 里失败的用例" > runs/a.jsonl
# B:结构化文件工具
pi --tools read,grep,find,ls,edit,write,bash --mode json "修复 tests/test_parser.py 里失败的用例" > runs/b.jsonl
# C:只留 bash
pi --tools bash --mode json "修复 tests/test_parser.py 里失败的用例" > runs/c.jsonl每跑完一组,把仓库恢复到同一个提交再跑下一组(git stash -u 或 git checkout . 加 git clean),否则后一组拿到的是改过的代码。
第三步:从事件流里算 token、轮次和钱
JSON 模式每条消息结束会输出 message_end,助手消息都带 usage,里面有输入、输出、缓存读写 token 和按价格换算的 cost:
for f in runs/*.jsonl; do
  jq -s --arg f "$f" '[.[] | select(.type=="message_end" and .message.role=="assistant") | .message.usage] |
    {run:$f, turns:length,
     input:(map(.input)|add), output:(map(.output)|add),
     cacheRead:(map(.cacheRead)|add), cost:(map(.cost.total)|add)}' "$f"
done
再跑一遍任务自带的检查(比如 pytest),把通过与否和上面几列放进同一张表。缓存命中率可以粗算成 cacheRead / (input + cacheRead)。交互模式下也能随时 /session 看当前会话的 token 和花费。
第四步:多跑几次再下结论
演讲里每题只跑了一次,他自己也说得分的小差异可能是噪声,需要每种外壳多采几次样。自己做时,每个任务每种组合至少跑三次,看中位数。得分持平而 token 明显少的那组,才值得换。新模型发布后,把这张表重跑一遍:他的做法是每隔几个月把外壳全删掉重来,看哪些东西模型已经不需要了。
常见坑
- 看图:只给 bash,截图、设计稿进不了模型的视觉输入。要么像演讲里那样补一个看图工具,要么保留能读图片的
read(Pi 的read支持图片)。 - 安全审计变难:bash 命令很难事先看懂要做什么。演讲结尾也提到,用 TypeScript 或 Python 包一层的 code mode,可以逐条看到被执行的操作再放行。生产环境要配沙箱和权限规则,站内 Claude Code Code Mode 实操 讲了另一种批量调工具的做法。
- 弱模型不吃这套:每次 bash 只跑一条命令的模型,删工具省不了什么,反而可能更容易出错。先看你用的模型在 bash 里能不能把命令串起来。
- 只比通过率:几种外壳通过率接近时,选择依据就是 token、轮次、耗时和每题成本,这几列一定要记。
完成标准
- 同一批任务、同一个模型、三种工具组合各跑过至少三次,仓库每次都从同一个提交开始。
- 手里有一张表:通过率、平均轮次、输入输出 token、缓存读取、每题成本。
- 能说清你的模型在只有 bash 时,一次调用平均串几条命令。
最后
下次准备给 Agent 再加一个专用工具之前,先拿 10 个真实任务跑一遍「只留 bash」,把每题成本记下来再决定。外壳怎么选、规则该写在哪,可以接着看站内的 Agent harness 成本对比。