JiTTests 是什么:让 AI 给每次改动写会失败的测试
编程 Agent 一天能交好几个 PR,测试却还是老办法:人写、人审、人维护。Meta 的做法反过来,每来一个改动,让大模型现场写一批专门针对它的测试,目标是让测试失败,失败就说明这次改动可能引入了回归。这套方法叫 Catching JiTTests(即时捕获测试),10 月 29 日 Meta 工程博客公布了上线结果。这篇讲清它的流程,再拆成一套你能在自己仓库里照搬的简化做法。
适合谁、需要什么
适合已经在用 Claude Code、Codex 这类编程 Agent 写代码,PR 多到人工审不过来的团队;也适合想给 Agent 代码审查再加一层保险的人。前置条件有三个:仓库有能在命令行跑的单元测试框架(pytest、Jest、JUnit 都行),能用 git 切出改动前后两个版本,手上有一个能读代码、写测试、跑命令的编程 Agent。
捕获测试和平时写的测试差在哪
平时写的测试叫加固测试(hardening):写完当场要通过,用来防以后有人改坏。问题是写的人得猜未来会怎么改,猜不准就要么什么都抓不到,要么一碰就误报。Agent 写代码越快,这些测试的维护成本越高。
捕获测试(catching)只盯一个改动。论文给了两个说法:测试在新版本上失败,叫「弱捕获」;这个失败确实是 bug,才叫「强捕获」。整套系统的难点就在于从一堆弱捕获里挑出强捕获。测试本身不进代码库,用完就丢,所以没有维护成本。
| 方式 | 什么时候生成 | 怎么判断有问题 | 要人做什么 |
|---|---|---|---|
| 加固测试 | 写功能时,长期保留 | 以后某次改动让它失败 | 写、审、维护测试代码 |
| LLM 代码审查 | PR 提交时 | 模型读代码给意见 | 逐条看评论 |
| 捕获测试 | PR 提交时,用完即弃 | 父版本通过、新版本失败 | 只回答「这个行为变化是预期的吗」 |
Meta 在博客里强调,捕获测试拿出来的是一个能跑的测试,证明行为确实变了。它比单纯的代码审查多花算力,但能抓到审查漏掉的那类 bug。
Meta 的五个阶段
- 挑改动。系统夜里用空闲算力跑,只处理前一天提交、被风险模型(类似 Diff Risk Score,用历史改动训练)判为高风险的 diff。生成捕获测试很费算力,要用在最可能出大事的地方。
- 两条生成流程并行。「意图感知」流程先让模型根据代码、标题和描述推断这次改动想干什么,再列出实现时可能出错的地方(风险),按每条风险在父版本上造一个变异体(故意埋 bug 的版本),生成能区分变异体和父版本的测试。「可疑 diff」流程不推断意图,直接把整个改动当成一个变异体来生成测试。两条流程产出的测试都拿到真实改动上跑,失败的收进弱捕获池。
- LLM 裁判。几个模型(论文点名 Llama3.3-70B、Gemini 3 Pro、Claude Sonnet 4)各自看测试代码、失败信息和执行轨迹、diff、推断出的意图,判断这是不是意外的 bug,最后取中位数。
- 规则过滤(RubFake)。LLM 的判断不确定、也难核实,所以另配一套确定性规则,专认常见误报,两边合起来给候选排序。
- 按需找人。排得够靠前的,才发给改动作者确认。人不再逐条审测试,而是定标准、看整体结果,Meta 管这叫 human-on-the-loop。
数字:意图感知效果最好
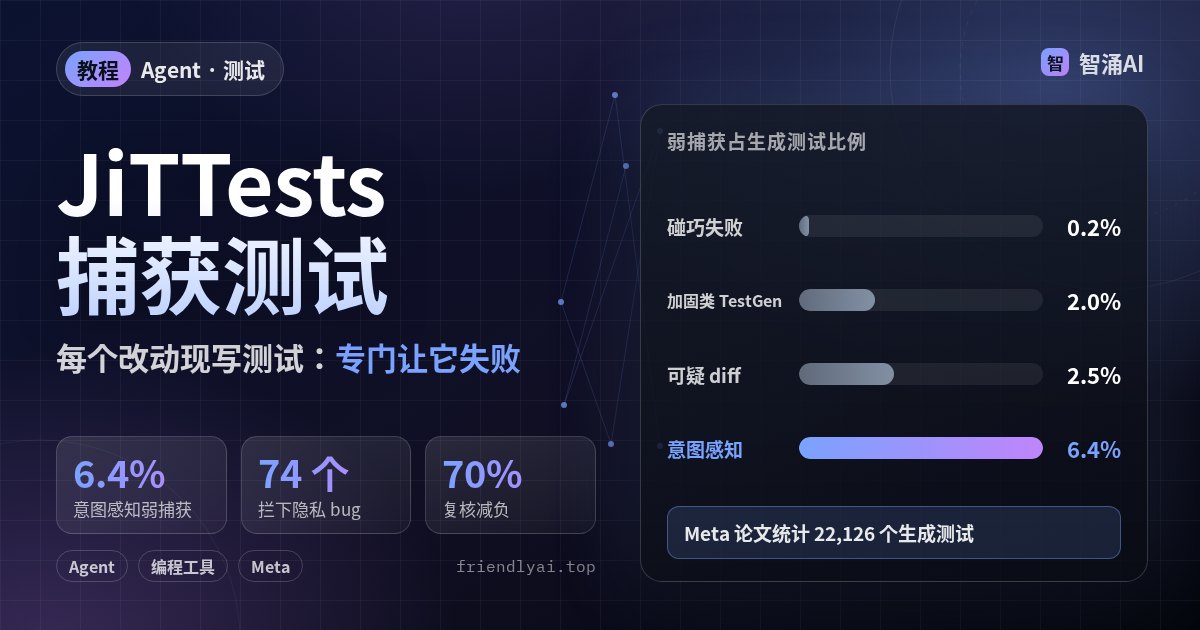
论文统计了 22,126 个生成的测试。改动时碰巧失败的测试只占 0.2%;不看 diff 的加固类方法在 0.8% 到 2.0%;可疑 diff 流程 1,621 个测试出了 41 个弱捕获(2.5%);意图感知流程 811 个测试出了 52 个(6.4%),并且在 7.9% 的 diff 上至少抓到一个,差不多是可疑 diff 流程(4.0%)的两倍。
初期人工复核时,论文作者向工程师发了 41 次提醒,8 次被确认是真 bug,其中 4 个若进了生产会造成严重故障。LLM 裁判帮人工复核省了约 70% 的工作量。到 10 月的博客,589 名工程师(占联系人数的 64%)用过这套系统,反馈真阳性率 60%;2026 年上半年它在 diff 阶段拦下 74 个严重隐私 bug,同期隐私类严重事故少了 20%。
别把测试代码甩给工程师去调。论文的经验是:直接告诉他「这个表达式以前是 true,现在是 false,是预期的吗」,几秒钟就能答。
自己搭一个简化版:四步
Meta 的规模和风险模型照搬不来,但流程可以缩成一个 PR 级的小工作流,交给编程 Agent 执行。下面以 Python + pytest 为例,换语言只需换测试命令。
第 1 步:只挑高风险 PR。先别全量跑。按路径圈出权限、计费、隐私、数据删除这类改坏了代价大的目录,只对碰到它们的 PR 触发。
第 2 步:让 Agent 推断意图和风险。把 diff、PR 标题和描述交给它:
读这次改动(git diff origin/main...HEAD)和 PR 描述。
1. 用两三句话写出这次改动的意图。
2. 列出 3–5 条「实现这个意图时最可能出错」的风险,每条写清会坏在哪个函数、什么输入下。
只输出意图和风险,不要改代码。
第 3 步:在父版本上生成测试,在新版本上跑。用 git worktree 把父版本切到旁边目录,测试放在仓库外,不提交:
git fetch origin
git worktree add ../wt-parent origin/main
mkdir -p /tmp/jit        # 让 Agent 把测试写在这里

# 测试必须在父版本上全部通过
(cd ../wt-parent && python -m pytest -q /tmp/jit)
# 再在改动上跑,失败的就是弱捕获
python -m pytest -q /tmp/jit
给 Agent 的要求写清楚:每条风险至少一个测试;测试只通过公开接口断言行为;在父版本上跑不过的测试直接删掉。python -m pytest 会把当前目录加进导入路径,所以同一份测试在两个目录里分别导入各自版本的代码;你的项目如果另有导入方式,要按实际调整。
第 4 步:过滤再报告。先按下一节的规则去掉明显的误报,剩下的再让另一个模型当裁判,输入照 Meta 的四样:测试代码、失败输出、diff、意图。最后每条只写一句行为变化,贴进 PR 评论问作者是不是预期的。作者说是,这条就作废;说不是,再去看测试代码。跑完用 git worktree remove ../wt-parent 清掉临时目录。
常见坑:这些失败多半是误报
论文整理了一张误报规则表,下面几条最容易碰到,可以直接写进给裁判的提示词:
- 测试环境自己挂了:测试运行器出错、依赖的服务没起来,跟改动无关。
- 测实现细节:用反射、断言某个函数被调了几次、要求键值对顺序一致、强制某个方法必须是私有的,改动一重构就失败。
- 类型或签名本来就改了:改动有意改了方法类型或删了变量,测试还按旧的写。
- mock 或测试数据写错:模型经常 mock 错、造错数据。
- 故意抛的未实现异常:作者先加签名、留了 NotImplemented,属于预期。
反过来,论文认为这类失败更值得找人:改动没碰某个容器或键,它却变空、越界了;没改对象结构,对象却建不出来了;某个布尔值从 true 变成 false,代码里却没改定义它的表达式。
完成标准
- 只有高风险目录的 PR 会触发,测试不进代码库。
- 每个生成的测试都先在父版本上通过。
- 弱捕获先过规则过滤,再过模型裁判。
- 发给作者的是一句行为变化加一个问题,不是一段测试代码。
最后
先挑一个你最怕改坏的目录,把上面四步跑在下一个 PR 上。想让 Agent 写的代码更容易被测试兜住,可以接着看代码库适配 Agent:类型与快照测试;想把测试和评测接进 Agent 开发流程,见Agent 评测驱动开发。
- Engineering at Meta:Catching Bugs Before They Land: JiTTesting’s Human-on-the-Loop Approach at Full Scale(2026-10-29)
- Engineering at Meta:The Death of Traditional Testing…JiTTesting Can Revive It(2026-02-11)
- arXiv 2601.22832:Just-in-Time Catching Test Generation at Meta(FSE 2026)
- Git 官方文档:git-worktree