Agent 评测驱动开发怎么做:先写评测再改提示词
给 Agent 改提示词、加工具,最怕的是改完不知道变好还是变坏:手动问三五个问题,看着没问题就上线,过两天发现另一类问题坏了。LangChain 在 2026-11-09 发了一篇长文,把他们做 Agent 用的「评测驱动开发」(Eval-Driven Development,EDD)拆成三步。这篇按原文的例子讲清每一步具体写什么,再补上 CI 和线上怎么接着跑。
Agent 的测试为什么要换个写法
EDD 的名字借自测试驱动开发(TDD):先写一个会失败的测试,再写代码让它通过。区别在于 Agent 不是确定性的程序。原文列了三点:同一个问题每次回答可能不一样;两种措辞不同的回答可能都对;Agent 自己决定走哪几步,可能多调了一个工具、少调了一个工具,最后答案照样对。
所以 Agent 的「测试」是评测(eval):在一组样本上跑 Agent,给每次运行打分。分可以打在任何环节上,最终回答、某一步工具调用、整段多轮对话都行;判断不了对错的,可以交给另一个模型当裁判(LLM-as-a-judge)。
第一步:写一份能判对错的小规格
先列出 Agent 要做的几类行为,合起来相当于 Agent 的需求文档。EDD 一次只改一种行为,这样一个改动的效果不会被另一个改动搅浑。要改的行为,通常来自马上要做的新功能,或者在过去的运行记录里翻到的失败。
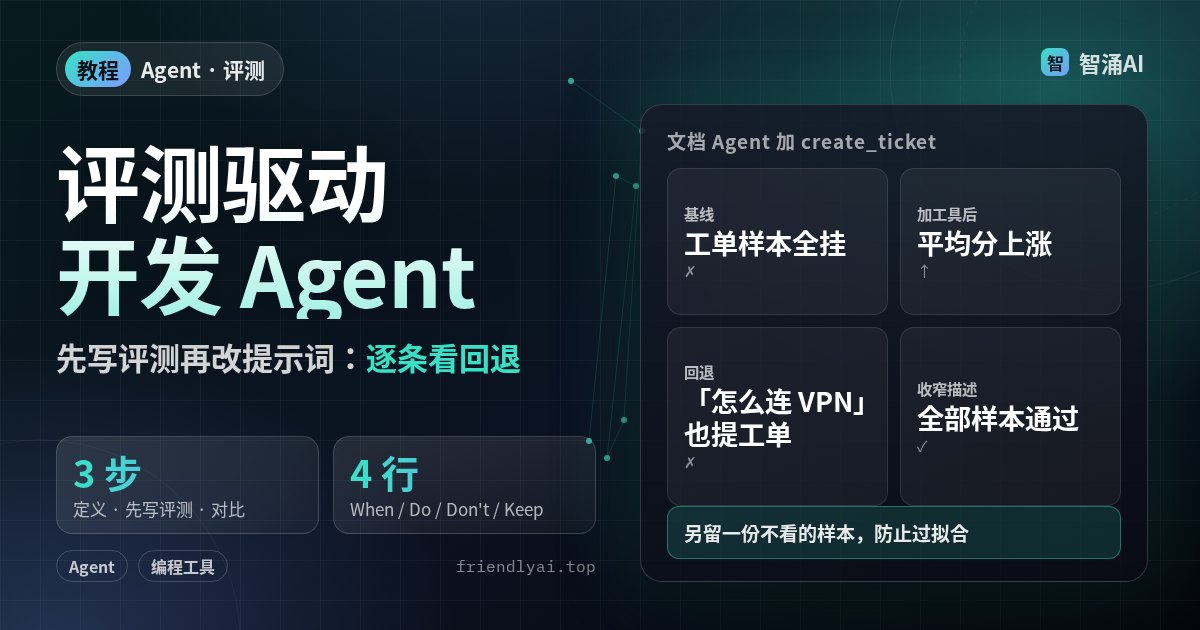
动手前,给这一种行为写一份四行规格。原文的例子是一个公司内部文档问答 Agent,已有 search_docs(查内部文档)和 web_search(查外网)两个工具,现在要加一个 create_ticket 用来提 IT 工单:
| 项 | 写什么 | 例子里的写法 |
|---|---|---|
| When | 什么情况下该触发 | 用户报告东西坏了,比如「我的笔记本连不上 VPN」 |
| Do | 该做什么 | 调用 create_ticket |
| Don't | 不该做什么 | 「怎么连 VPN?」这种操作问题不提工单 |
| Keep intact | 哪些老行为不能坏 | search_docs 和 web_search 照旧处理原来那些问题 |
规格要写到能直接判「过 / 不过」的程度。「回答要有帮助」这种写法没法打分,原文把它列为最常见的错误之一。
第二步:先写评测,再写功能
建数据集。数据集就是一组样本,每条有输入,可以带一个参考答案。最好的输入来自真实运行记录,用户的说法和边界情况往往是你自己想不到的。还没有线上流量时,就手写几条。例子里只需要一小把:几条该提工单的报障,再加几条仍该走 search_docs、web_search 的问题,参考答案写「应该调哪个工具」。
覆盖不够的类型可以让模型帮忙扩。原文的做法是把现有样本交给模型,让它改写成更生气、更急的语气,再看 Agent 还会不会调对工具。
写评分器。能用代码确定判断的,用代码;判断不了的,才用 LLM 裁判。例子要看的是「调没调对工具」,代码一行就能比较,所以用代码评分:调用了参考答案里的那个工具就算过。
def correct_tool(run, example):
    called = [step.tool for step in run.tool_calls]
    return example.expected_tool in called
上面这段是示意写法,字段名要换成你所用框架的实际结构。
跑基线。功能还没做,先把当前版本在全部样本上跑一遍,存成一次「实验」:每条样本的输入、输出、得分记在一起。提工单的样本此时全不过,这是预期的;其余样本记下的是「现在什么是好的」,后面拿来判断有没有改坏。
评测要在改动之前写,并且先确认它在当前版本上确实失败。看过新输出再写评测,很容易写成一个注定通过的评测。
第三步:改完逐条对比,别只看平均分
加上 create_ticket 后,用同一个数据集再跑一次,和基线并排对比。例子里是这样的:提工单的样本都过了,平均分涨了;可「怎么连 VPN?」这条老问题也开始提工单,变成了回退。
原因要看这次运行的完整轨迹(trace),也就是每一次模型调用和工具调用的记录。轨迹里能看到,工具描述写的是「用于 VPN 和笔记本问题」,于是任何提到 VPN 的问题都被匹配上了。把描述收窄到「需要 IT 动手处理的请求」,再跑一遍,全部样本通过。
全过不等于可以收工。描述是盯着这几条样本调出来的,一直调到 100%,Agent 可能只是记住了数据集。办法是另留一份调参时不看的样本:调参用的样本分数在涨、留出样本纹丝不动,多半就是过拟合了。
Agent 会改文件时,要检查它留下的结果
文档问答 Agent 只看工具调用和最终回答就够了。编程 Agent 这类会在沙箱里改文件、跑命令的,光看几次工具调用说明不了什么,要检查它跑完后环境变成了什么样,而且每次运行都要一个干净环境,免得上一次影响下一次。
原文点名的工具是 Harbor:一个开源框架,每个任务在独立沙箱里跑,附一个测试脚本给最终状态打分,Terminal-Bench 这类行业基准就用它当测试工具。GitHub 上 harbor-framework/harbor 为 Apache-2.0 许可证,截至 2026-11-10 约 6,900 星。LangChain 说他们也用它测 Deep Agents,看能不能砍掉待办清单中间件或部分系统提示词而不变差。
上线后让评测接着跑
- 合并前:快的代码检查放进每个 PR,挡住明显的回退;慢的、要 LLM 裁判的评测放到夜里或发版前跑。迭代时只跑和当前行为有关的那部分样本,发版前跑全量。原文提到 LangSmith 能接 pytest 和 Vitest,评测可以和代码放在一起。
- 线上:对实时轨迹按比例抽样打分,控制成本;可疑的运行进人工复核队列;仪表盘按时间看分数、反馈、成本和延迟。
- 回流:线上发现的失败,整理成新样本补回数据集,下一轮改动就要过这一关。
常见坑
- 评测越加越多。每个评测都会把 Agent 往某个方向推。每加一个,都要对应一个具体的修复或功能。
- 裁判没校准就用。先拿 LLM 裁判的打分和人工打分对一遍;问它窄问题,让它判「过 / 不过」,别用含糊的 1 到 10 分。
- 一次改好几处。工具描述、系统提示词、模型一起换,分数变了也说不清是谁的功劳。一次只动一处。
- 只盯平均分。平均分涨了,也可能有老样本悄悄坏掉,决定保留改动前逐条看一遍。
完成标准
- 手上这种行为有一份四行规格,每一条都能判过或不过。
- 数据集里既有新行为的样本,也有「不能坏」的老行为样本,另有一份留出集。
- 有一次基线实验,新功能样本在基线上是失败的。
- 改动后的实验和基线逐条对比过,没有未解释的回退。
- 快的检查已经挂进 CI,线上失败有地方回流成新样本。
最后
不用等数据集「够大」才开始。挑一个最近让你头疼的失败,先写四行规格和五六条样本,跑出基线再动提示词。想自己搭一套更像样的基准,可以接着看 Agent 评测基准设计清单;想比较不同 Agent 外壳的成本,见 同模型换 Agent 外壳。