Shopify 让 Agent 攻击自家生产环境:靠裁判 Agent 兜底
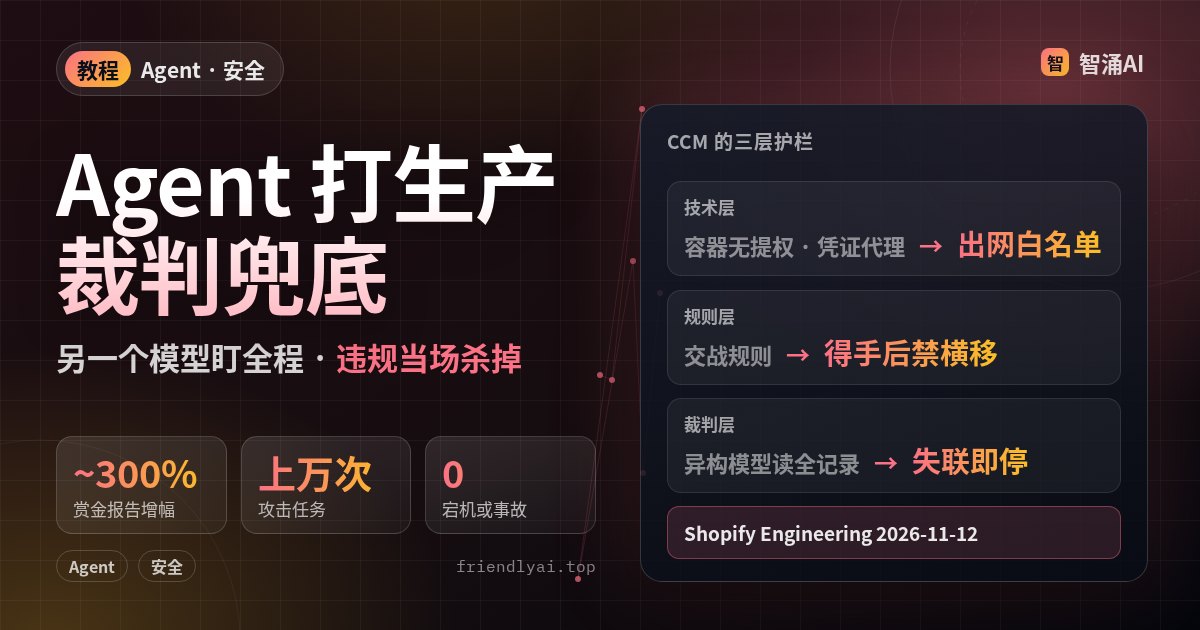
把真凭证交给 Agent,让它去攻击自家的线上系统,怎么看都像在等事故。Shopify 安全团队 11 月 12 日公开的 Cyber Chaos Monkey(CCM)就是这么做的:Agent 拿着源码、历史漏洞报告、基础设施记录和测试店铺的临时凭证,直接对生产环境发起攻击。官方说已经跑了上万次攻击任务、找到并处理了几十个有分量的问题,没出过一次宕机或事故。这篇拆它的护栏怎么搭,哪些做法能搬到你自己跑 Agent 的场景里。
为什么要在生产环境里打
Shopify 给的背景是:前沿模型把找漏洞的成本压得越来越低,自家漏洞赏金项目的报告量从 2024 年至今涨了近 300%,审核、复现、处理都吃力。他们的判断是,攻击者能用的模型自己也能用,而自己手里有外人没有的信息:源码、内部情报、历史报告、部署记录。把这份信息优势和模型结合起来,就能抢在外人前面找到最要紧的问题,也让外部攻击者找剩下问题的成本高到不划算。
攻击者打的是生产系统,所以测试也要打生产系统。名字致敬 Netflix 2011 年推出的 Chaos Monkey,那是随机关掉生产实例来检验系统韧性的工具,CCM 把这套混沌工程思路搬到了安全上。
一次攻击任务怎么跑
每次任务(engagement)围绕一个可能的漏洞或一个安全目标展开。起点可以是安全工程师的想法、上游其他安全 Agent 的输出,或 Discovery 自己的反馈循环;可以很具体(「在其他地方找和这份赏金报告类似的风险」),也可以很抽象(「拿到 Shopify 后台的远程代码执行」)。流程六步:
- 想法作为输入交给 Discovery;
- 用最新的安全向模型细化想法,在代码或配置里定位可能出问题的地方;
- 发现有希望的线索,把结构化描述发给 Sandbox;
- Sandbox 里的 Agent 动手测试,比如装依赖、写 fuzzer;
- 测完写报告,发回 Discovery 并往上汇报;
- Discovery 分析结果,按需要再生成新任务。
官方提到一个很实在的发现:Sandbox 里最好用的手段,是对 Shopify 发真实请求、去读生产日志看请求被怎么处理、再对照源码,一轮轮迭代。日志和源码,外部攻击者一样都拿不到。
技术护栏:常规但一样不少
CCM 本身是标准的容器化工作负载。每个任务对应一个 k8s Job,Pod 里的主容器是基于状态机的编排器,攻击 Agent 和维护任务都在 sidecar 容器里跑。
| 护栏 | CCM 的做法 | 你可以怎么借 |
|---|---|---|
| 最小权限 | 攻击 Agent 容器无提权;只拿到临时的 Shopify 凭证(会话 cookie、CSRF token),由编排器写进共享卷,Agent 只读不能改 | 给 Agent 的账号用短期、只读挂载的凭证,任务结束即失效 |
| 凭证代理 | 调内部知识服务和模型时,Agent 只带占位 header,代理替换成真凭证再经出网代理发出;哪个 header 能注入到哪个域名有严格限制,凭证定期轮换 | 真 key 永远不进 Agent 环境,由代理按域名注入 |
| 出网控制 | 出网代理是 nginx 上的白名单,只有它的 Pod 能出 VPC;只放行 Shopify 生产域名、知识服务、模型提供方和少数包管理源 | Agent 沙箱默认断网,按需白名单 |
凭证代理这一条,Anthropic 在给常驻 Agent 的架构建议里也推荐同样的做法:Agent 发不带凭证的请求,由环境外的代理注入。站内 常驻 Agent 安全配置 一文讲了更多分层做法。
行为护栏:让另一个模型盯着它
技术护栏防的是泄露凭证、逃出网络。CCM 还要防另一类风险:Agent 不按规矩来。第一层是交战规则(Rules of Engagement):对目标可以尝试任何攻击,但一旦攻击得手,有硬性限制,比如不许横向移动到其他系统、不许保留访问权限。
第二层,Shopify 不相信执行 Agent 能从头到尾守规矩。他们借用了「双人复核」(two-person integrity):执行方的动作要由第二方审查。CCM 的做法是把攻击 Agent 的会话记录实时喂给另一个 Agent,这个裁判用的是不同的模型、不同的提示词,读执行方的全部事件,包括回复、思考过程、工具调用和调用结果。一旦发现违反交战规则的行为,裁判调用一个工具,立刻杀掉攻击 Agent。
裁判超时、崩溃或不再给出判定,任务直接结束,默认状态是停。
这套机制要求「明确的正向控制」。编排器作为 Pod 主容器,和执行方、裁判两个 sidecar 都保持心跳,任何一方死掉编排器就退出;Pod 的重启策略不允许编排器重启,于是 k8s 把两个 sidecar 一起拆掉,任务终止。三者放在同一个 Pod 里(彼此隔离),减少网络分区打断通信的可能;k8s 驱逐 Pod 时也会一起终止,不会留下一个没有裁判看着的执行容器。
搬到自己的 Agent 上:三个可落地的改法
- 写一份交战规则。别只写「不要做危险操作」,按 CCM 的结构写清两部分:允许尝试的范围,和得手后绝对禁止的动作。例如:
允许:对 staging 环境的 /api/* 发任意请求,读取 staging 日志 得手后禁止:访问其他服务、创建新账号或密钥、保留会话、修改数据 发现可利用问题:立即停止,写报告,等待人工 - 加一个异构裁判。用另一家模型实时读执行 Agent 的工具调用日志,只给它一个能力:判定违规并终止任务。同一个模型审自己,容易犯同样的错。
- 默认停止。监控进程和执行进程绑在一起,监控方没响应就杀掉执行方,别反过来设计成「监控挂了照常跑」。
Claude Code 用户可以用 hooks 做一个简化版:PreToolUse hook 把每次调用交给审查脚本。注意官方文档的说明:多数事件上 hook 失败或超时,Claude Code 照样执行动作;要做到「审查挂了就拦」,得在 command 或 http hook 上设 "onFailure": "block"(需要 v2.1.295 及以上)。
常见坑
- 只做技术隔离:容器和网络管住了 Agent 能碰到什么,管不住它在允许范围内做了越界的事,比如拿到权限后顺手留个后门。行为层要单独设计。
- 裁判和执行方用同一个模型、同一套提示词:CCM 刻意让两者「对齐方式不同」,就是为了避免同样的盲区。
- 监控失败时放行:裁判挂掉后继续跑,等于没有裁判。
- 把真凭证写进环境变量:Agent 能读到的东西就可能被带出去,用代理注入。
完成标准
- Agent 的运行环境里找不到长期有效的真实凭证。
- 出网只允许白名单域名。
- 有一份写明「可以试什么、得手后不能做什么」的交战规则,并加载进 Agent。
- 有独立的监控方读完整调用日志,能终止任务;监控方失效时任务自动停止。
最后
如果你已经让 Agent 拿着真凭证干活,今天先做一件事:把它环境里的 key 挪到一个按域名注入的代理后面。