编程 Agent 先用便宜模型:Switchyard 路由上手
编程 Agent 改一个 bug 可能要调十几次模型,每次都走最贵的模型,账单涨得很快;全换便宜模型,又怕任务做不完反复重试。AWS 机器学习博客 11 月 13 日给了一套可以照抄的做法:本地或 AWS 上起一个 LiteLLM 网关,挂上 NVIDIA 开源的 NeMo Switchyard 路由插件,新请求先交给便宜模型,工具结果显示出错了再升级到强模型,最后用「每个解决任务的成本」判断这样配到底划不划算。这篇按 AWS 博客和示例仓库 README 把流程整理成五步。
只看每 token 单价,会算错账
AWS 文章开头就讲清了:开发者真正付钱的是「一个任务」,一个任务的总成本取决于要跑几轮、每轮重放多长的历史、多少次重试,以及最后没做完的那些尝试。所以它建议用 cost per solved task 衡量路由:所有运行的总花费,除以测试通过的运行次数。
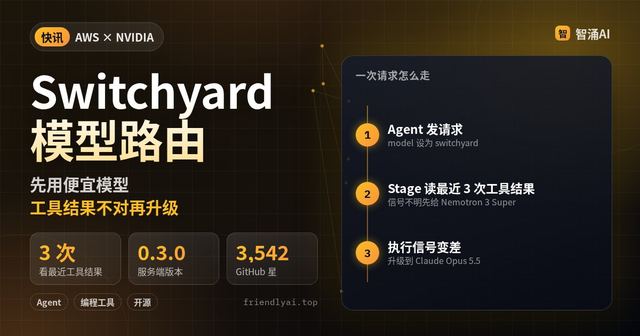
Switchyard 在 LiteLLM 集成里支持两种策略。Stage 读取请求历史里最近的工具调用和结果,在一强一弱两个候选里挑一个;Random 按权重随机分流,适合做 A/B。两种都不调用裁判模型。需要先调一次分类模型的 Task、Composite 等策略,这个集成不支持。
| 对比项 | Stage 路由 | Random 路由 |
|---|---|---|
| 候选模型数 | 正好 2 个(强模型在前) | 至少 2 个 |
| 依据 | 最近几次工具结果里的执行信号 | 权重,如 [0.5, 0.5] |
| 新请求去哪 | 默认便宜模型 | 按权重随机 |
| 适合 | 日常编码,出错再升级 | 对比两个模型的效果 |
前置条件
- 一个非生产 AWS 账号,已开通 Bedrock 上 Claude Opus 5.5 和 NVIDIA Nemotron 3 Super 120B 的访问。AWS 写明这组模型在 us-east-1 测过,别的区域要自己查可用性和工具调用支持。
- AWS CLI v2(配好凭证和区域,且该区域做过 CDK bootstrap)、Node.js 20+、npm、带 BuildKit 的 Docker、Python 3.11+。
- 正式部署要一个自己的域名(Route 53 托管区或现成的 ACM 证书);只在本机试,不需要。
git clone https://github.com/aws-samples/sample-route-coding-agent-requests-Amazon-Bedrock-nemo-switchyard.git
cd sample-route-coding-agent-requests-Amazon-Bedrock-nemo-switchyard
示例装的是 crates.io 上的 switchyard-server 0.3.0,跑的是 LiteLLM v1.102.0 镜像。NVIDIA 把 0.3.0 定位为演示和评估组件,LiteLLM 集成也标着实验性,配置可能随版本变。
第一步:在 LiteLLM 里定义模型组
配置放在 profiles/stage/,litellm.yaml 管模型,switchyard.toml 管怎么选。两个候选共用同一个 model_name: switchyard:
model_list:
  - model_name: switchyard
    litellm_params:
      model: bedrock/converse/global.anthropic.claude-opus-5-5
      aws_region_name: os.environ/AWS_REGION
  - model_name: switchyard
    litellm_params:
      model: bedrock/converse/nvidia.nemotron-super-3-120b
      aws_region_name: os.environ/AWS_REGION
  - model_name: claude-opus-5-5          # 单模型基线组
    litellm_params:
      model: bedrock/converse/global.anthropic.claude-opus-5-5
      aws_region_name: os.environ/AWS_REGION
  - model_name: nemotron-super-3-120b    # 单模型基线组
    litellm_params:
      model: bedrock/converse/nvidia.nemotron-super-3-120b
      aws_region_name: os.environ/AWS_REGION
router_settings:
  plugins:
    - switchyard_gateway.configured.ROUTING_PLUGIN
litellm_settings:
  callbacks:
    - switchyard_gateway.configured.ROUTING_PLUGIN
  drop_params: true
  request_timeout: 600
  num_retries: 2
general_settings:
  master_key: os.environ/LITELLM_MASTER_KEY
客户端发 "model": "switchyard",由插件挑候选。强模型写第一个、便宜模型写第二个,Stage 靠这个顺序认角色。另外两个单模型组是基线,后面算成本时拿来对比。插件注册两次:一次选模型,一次应用 Switchyard 记下的请求改动。
第二步:配置 Stage 路由
algorithm = "stage"
picker = "efficient_first"
confidence_threshold = 0.5
recent_window = 3
only_on_wrong_signal_escalation = trueefficient_first:历史信号说不清时用便宜模型。新请求还没有工具结果,所以先到 Nemotron 3 Super。confidence_threshold:执行信号的置信度阈值,0 到 1。recent_window = 3:只看最近 3 次工具结果。only_on_wrong_signal_escalation:Switchyard 默认值,控制何时附加升级提示,示例没设提示。
想做 A/B,换用 profiles/random/(algorithm = "random"、weights = [0.5, 0.5])。改完配置先离线校验,不调 AWS:
npm run validate:profile -- stage第三步:本机起网关并冒烟测试
npm ci
cp .env.example .env
export LITELLM_MASTER_KEY="sk-$(openssl rand -hex 24)"
eval "$(aws configure export-credentials --format env)"
ROUTING_PROFILE=stage docker compose up --build --wait
GATEWAY_URL=http://127.0.0.1:4000 ROUTING_PROFILE=stage scripts/smoke-test.sh
Compose 只把网关发布在 127.0.0.1,AWS 凭证只来自当前 shell,不写进 .env。冒烟测试会检查健康接口、无 key 返回 401、/v1/models 列出所有组;对 Stage,还会验证普通请求选便宜模型、带一串连续失败历史的请求升级到强模型。本地网关调用 Bedrock 照样计费,用完 docker compose down。
手动发一条看选了谁:响应头 x-litellm-model-name 写着实际作答的模型,响应体里的 model 字段始终是 switchyard。
curl -sS -i "$GATEWAY_URL/v1/chat/completions" \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"switchyard","messages":[{"role":"user","content":"Reply with the word hello."}],"max_tokens":128}'
第四步:部署到 AWS(可选)
CDK 会把 LiteLLM 和插件打成一个镜像,跑在私有子网的 ECS Fargate 上,前面是 WAF 和负载均衡。先跑只读的 scripts/preflight.sh,再 npx cdk diff / npx cdk deploy,必须传 allowedCidr,示例用的是你当前公网 IP 的 /32,0.0.0.0/0 和 IPv6 段会被拒绝。负载均衡只放行 /v1/chat/completions、/v1/models 和 /health/liveliness,其余路径一律 404,管理界面和 key 管理接口因此碰不到。空闲超时 10 分钟,和 LiteLLM 的 600 秒请求超时对齐;WAF 每个 IP 限 5 分钟 2,000 次请求。
接自己的 Agent:base URL 填 $GATEWAY_URL/v1,API Key 填网关 key,模型填 switchyard。
第五步:算每个解决任务的成本
python3 bench/run.py --list-tasks
python3 bench/run.py --tasks slugify --model switchyard --max-turns 6
python3 bench/run.py --tasks slugify --model claude-opus-5-5 --max-turns 6
python3 bench/run.py --tasks calc --model switchyard --max-turns 12
自带 4 个任务:slugify(修 URL slug 函数)、roman(罗马数字)、calc(不用 eval 的表达式解析器)、lru_ttl(带过期的线程安全 LRU 缓存)。默认 6 轮内测试通过算解决。跑完每个模型组一行:RUNS、SOLVED、ERRORS、COST/TASK、COST/SOLVED。费用按响应头里的模型和 token 用量,乘 bench/run.py 的 PRICES 表估算。
先比 SOLVED,再看 COST/SOLVED。解决得少的组,单次便宜,摊到每个解决任务上可能更贵。
想比整段对话,用 bench/multiturn.py --tasks slugify --scripts backend api --max-spend 2,每段对话默认封顶 1 美元(--max-conv-cost)。AWS 也提醒,示例任务很小,几次运行得不出结论,要换成自己代码库里的任务、加大 --repeats。
常见坑
- Claude Code 直连会 404。负载均衡只转发 Chat Completions,不转发 OpenAI Responses 和 Anthropic Messages 路径。用这两种协议的客户端,要先在本地容器里加路径测通,再重新部署。
- Agent 没发完整历史。Stage 靠历史里的工具结果做判断,每次请求都得带完整对话;上游适配器只支持文本消息、函数调用和文本工具结果,其他格式在推理前就报错。
- 难题升级反而更贵。Stage 只能在失败出现后升级,没法提前把难题交给强模型;升级那一轮还要重放整段失败过程。如果少数难题占了大头,AWS 建议把它们单独分到一个模型组。
- 成本显示 n/a。带缓存输入的轮次、PRICES 表里没有的模型、缺用量的响应都不计价。换模型时记得在 PRICES 里补一行,单价以 Bedrock 官方价格页为准。
- key 泄露没有花费上限。栈本身不设预算,WAF 只按请求数限流,不管 token 用了多少。部署前先建 AWS Budgets 告警,测完
npx cdk destroy。另外别把任何凭证写进litellm.yaml,栈会把整个文件明文放进任务定义和 CloudFormation 模板。 - 基准脚本会执行模型写的代码。测试子进程去掉了凭证,但不是系统级沙箱,能读你用户能读的文件、能联网。放在一次性开发环境里跑。
做到哪一步算完成
- 冒烟测试全部通过:普通请求落到便宜模型,连续失败历史升级到强模型。
- 同一批任务上,路由组和两个单模型组各有一行 SOLVED 与 COST/SOLVED。
- 根据这几行数据,给每类工作负载选定路由组、单模型组或换一组候选。
- 测试结束,
docker compose down或cdk destroy已执行。
事件本身见站内 AWS Switchyard 路由示例快讯;评测方法可以对照 Agent 评测驱动开发教程。
最后
挑 5 个你团队最近真实修过的小 bug 做成测试任务,在本地网关上分别跑路由组和强模型单模型组,每组至少重复几次,看 COST/SOLVED 谁低,再决定要不要切到路由。