Agent PR 审不过来?用 merge-risk 给合并打分
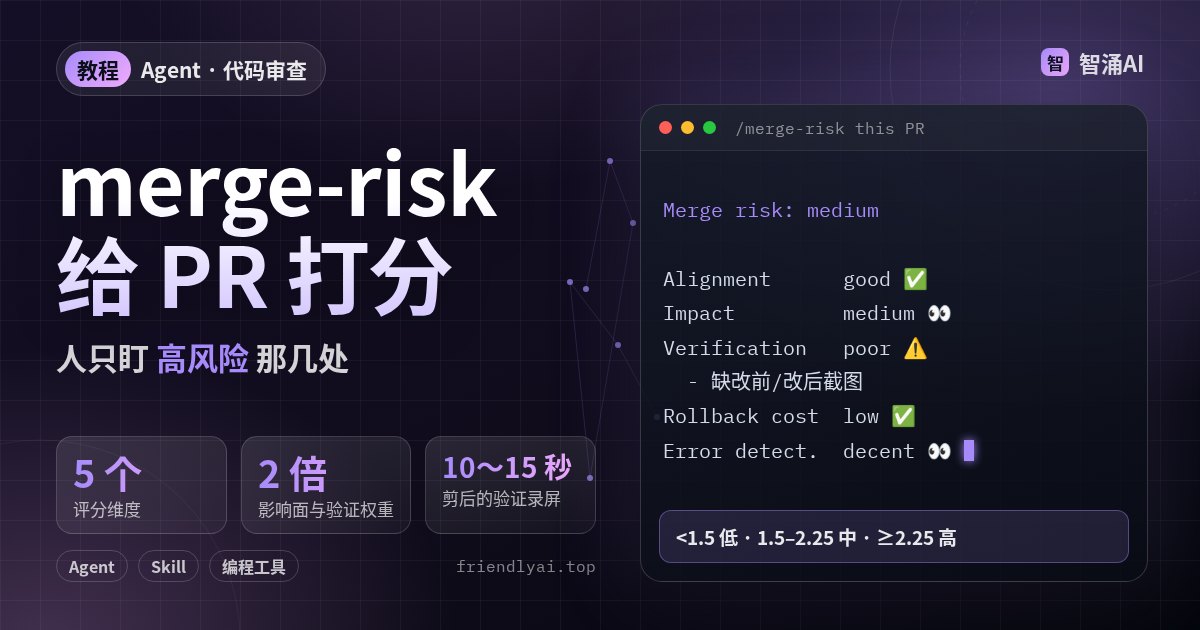
Agent 一天能交十几个 PR,人一天认真审不了几个,瓶颈就卡在审查这一步。Warp 在 2026-11-05 的工程博客里给了三招:先让 Agent 自己跑对抗式审查,再让它像用户一样把功能点一遍留证据,最后用开源的 /merge-risk Skill 给每个 PR 打低 / 中 / 高三档风险分,人只盯高风险的部分。这篇把三招拆开,重点讲 merge-risk 的打分规则和怎么接进自己的流程。
先说清目标:少花人眼,不是不审
Warp 的原文开头就把话说死了:现在不建议让机器人不经人审直接合并。三招的目的只有两个,让人更敢信 Agent 交的活,以及把「审完一个 PR」要花的人力压下来。所以 merge-risk 打出「低」也得有人看,只是可以看得快一点。
第一招:审查先在 Agent 之间打完
很多团队让审查 Agent 直接在 GitHub PR 下留评论。能用,但大部分评论其实用不着人看,PR 页面被刷得很吵。Warp 的建议是让实现 Agent 和审查 Agent 在 PR 之外来回过,只把需要人决定的意见放出来。他们的产品 Warp Factories 默认这样跑:
- 实现 Agent 写完,交给审查 Agent。
- 审查 Agent 列出问题清单,每条写严重程度、影响和建议改法;碰到超出已有产品决定的模糊点,交回给人(他们是回到发起任务的 Slack 线程)。
- 实现 Agent 处理能改的部分。
- 审查 Agent 再提新问题,循环到没有问题,或者到达设定的最大轮数 N。
多轮审查费钱。Warp 在试一个前置闸门,先判断这次改动要不要审;按他们在自家全栈系统上的早期测算,只对较大的功能跑多轮审查是可行的。具体数据他们说之后再公布,这里先不展开。
自己搭的好处是评分标准由团队定,还能用自己的数据调。原文提到一个思路:线上事故和回滚说明审查漏了东西,可以把它们转成评测用例,让审查 Agent 越审越准。评测怎么搭,可以接着看Agent 评测驱动开发那篇。
第二招:让 Agent 自己点一遍,留下证据
同事交一个自己没在本地跑过的 PR,你不会放心,Agent 也一样。Warp 给的做法分两类:
- 后端:把环境模拟得像真的。起一个预发数据库,给 Agent 注入测试凭据,记下访问日志,事后能看它做了什么。
- 前端和客户端:给 Agent 能像用户一样操作界面的工具。Web 应用可以用 Chrome DevTools MCP 或 WebMCP,这两个不绑定模型;更通用的是计算机操作(computer use),Agent 在自己的虚拟桌面上打开应用、点来点去。
验证完要把截图、录屏交给审查的人,而且要有改前和改后两个状态。Warp 建议把测试证据设成 PR 描述的必填项,Agent 默认就会去做。
也别验证过头。多张截图应该对应不同的用户流程,不要重复拍同一条;录屏要剪掉 Agent 两次操作之间的空档。Warp 给 Agent 加了 FFmpeg 后处理自动裁掉这些空白,按他们的经验,片段能从几分钟缩到 10~15 秒。
交给审查的人两样东西:改前改后的截图,和一句「这次改动回滚有多难」。
第三招:装上 merge-risk,按五个维度打分
merge-risk 在 Warp 的开源仓库 warpdotdev/common-skills 里(MIT 许可),是一个标准的 SKILL.md,Claude Code、Codex 这类支持 Skills 的 Agent 都能装。官方给的安装和用法:
npx skills add warpdotdev/common-skills --skill merge-risk

# 在 Agent 里对当前 PR 运行
/merge-risk this PR
它按五个维度给 PR 评级,每个维度三档,分别记 3 / 2 / 1 分(差 / 一般 / 好),再乘权重算加权平均:
| 维度 | 看什么 | 权重 |
|---|---|---|
| 影响面 Impact | 波及范围;是否碰到认证、权限、支付、个人信息、密钥、数据迁移、依赖升级、基础设施配置这类敏感路径 | 2 |
| 验证 Verification | 改动用户体验要有端到端截图或录屏,可能影响性能要有性能分析,最好是改前改后对比;边界情况要测,没测要写明 | 2 |
| 回滚成本 Rollback cost | 是「双向门」(能退回)还是「单向门」(比如破坏性的表结构迁移) | 1.5 |
| 错误发现 Error detection | 关键流程出错时,是否会在用户反馈之前被发现;有没有吞掉的异常、掩盖故障的兜底 | 1 |
| 对齐 Alignment | 代码是否符合 PR 描述和对应工单;顺手改的东西(drive-by)和行为假设要写明 | 1 |
加权平均小于 1.5 算低风险,1.5 到 2.25 之间算中,大于等于 2.25 算高。SKILL.md 要求分数和计算过程只在内部用,输出里只给结论:总体风险一行,然后每个维度一行评级,下面用短条目列出拉高风险的缺口,必要时附相关文件链接。
拿一个例子算一遍:影响面「中」(2)、验证「差」(3)、回滚「好」(1)、错误发现「一般」(2)、对齐「好」(1),加权和是 4 + 6 + 1.5 + 2 + 1 = 14.5,权重和 7.5,平均约 1.93,落在中风险。只要把验证补到「好」,平均降到约 1.4,就进了低风险档。验证和影响面权重最高,补证据和拆小 PR 最见效。
把 merge-risk 放在交 PR 之前
让 Agent 在提 PR 之前自己先跑一遍,把能降的风险降下来,人拿到的就是处理过的版本。Warp 列的几种处理:
- 删掉和任务无关的顺手修改,避免对齐维度扣分。
- 给新代码路径加错误监控。Warp 自己的做法是用 webhook 接 Sentry 告警,再转给 Agent 去查。
- 影响面大的改动拆成堆叠 PR(stacked PRs),一个个审。
- 能绕开敏感路径就绕开。
- 端到端验证,配截图和录屏。
可以在项目的规则文件里加一句类似这样的要求:
提交 PR 前运行 /merge-risk。结果为 medium 或 high 时,先按缺口逐条处理:
删除与任务无关的改动、补改前/改后截图、给新路径加错误上报、
必要时拆成多个 PR。处理后再跑一次,结果写进 PR 描述。
PR 模板里加三个字段
Warp 建议最先做的一步最简单:在 PR 描述里加「影响面」「回滚成本」,再加测试步骤。merge-risk 的 SKILL.md 注明参考了 Matt Pocock 公开的 pr Skill,那份模板长这样,可以直接抄:
## Summary
<一张图、diff 草图或文件树,选最能说明问题的那种>

## Evidence
- **Before:** <截图 / 输出 / 失败的测试>
  **After:** <截图 / 输出 / 通过的测试>

## Merge Danger
**Door:** <one-way 或 two-way>
**Blast Radius:** <一个词概括影响面>
有了这三块,审查的人打开 PR 先看 Door 和 Blast Radius,就知道这次该细看还是扫一眼。
常见坑
- 把「低风险」当成免审:评分只是帮你分配注意力。原文结尾专门写了「风险降低不等于零风险」,工程师仍要参与代码库怎么演进。
- 审查意见全刷在 PR 上:人会被噪音淹没,真正要拍板的那条反而漏看。内部循环解决掉的就别贴出来。
- 只有单元测试就算验证:merge-risk 的规则写得很明确,改了用户体验没有端到端截图或录屏,验证维度直接判差,而它的权重是 2。
- 多轮审查不设上限:一定要设最大轮数,或者像 Warp 那样先判断要不要审,否则成本会涨得很快。
- 录屏又长又空:几分钟的录屏没人看完,剪到只剩关键操作。
完成标准
- Agent 交上来的 PR 描述里有 Evidence(改前 / 改后)和 Merge Danger(Door、Blast Radius)。
- 审查 Agent 和实现 Agent 的来回不出现在 PR 评论里,只有需要人决定的问题会被提出来。
- 每个 PR 都附一行 merge-risk 结论,中高风险的已按缺口处理过。
- 团队约定好:高风险逐行审,低风险重点看证据和对齐。
最后
整套流程可以慢慢搭。今天就在 PR 模板里加上 Door 和 Blast Radius 两个字段,再装上 merge-risk 对最近三个 Agent PR 各跑一次,看看它标出来的缺口和你自己审时注意到的是不是同一批。